最近 clice 的 commit 数量已经来到了 1000,这是一个特殊的里程碑。并且从 2026-7-19 开始,clice 发布每日构建版本,截至目前已经进行了四个月左右的 alpha 测试,根据早期用户的实际反馈修复了大量错误。与此同时,我也为 clice 构建了精密的测试系统,在很多真实的开源项目上进行了广泛的测试,发现其中的错误并修复。这意味着什么?所有核心功能都已稳定,日常使用已经很少遇到问题。因此我认为时机已经成熟,是时候发布正式版了。现在项目的情况和两年前 一个新 C++ language server 的设计与实现 中的情况已经大不相同,并且这应该是第一次大规模地进行宣传,因此请允许我再一次为你介绍这个项目!这是我在过去两年半时间一直为之努力,最骄傲也最自豪,最让我激动也曾无数次让我难过焦虑,也是我短暂人生中最具有野心的项目。
What is clice?
简而言之,clice 是一个使用 现代 C++ 编写而成的 C/C++ 语言服务器,但不只是语言服务器。它仍然基于 LLVM/Clang,但与同样基于 Clang 的 clangd/ccls 不同,进行了彻底的 redesign,旨在彻底解决这些语言服务器中由于架构问题而数年无法解决的问题。它完全使用 C++23 编写,并且本身就是现代 C++ 的最佳实践,所有主要的现代 C++ 特性以一种奇妙的方式组合在一起,这体现在:
- 完全使用 C++20 coroutine 编写,使用我们基于 libuv 的结构化并发异步库编写复杂异步逻辑。它是在主线程上运行事件循环,多进程 (IPC)/多线程均有涉及的复杂并发程序
- 完全使用 C++20 named module 和 C++23
import std编写,并且完成了自举,三方库的模块包装是用clice modularize工具自动生成的,并且 clice 本身可以良好地运行在自身的代码库上,提供模块相关的语言服务 - 完全使用基于 template 和 C++20 concept 的 static reflection 技巧进行多种格式的序列化和反序列化。这包括 toml/json/bincode/blob/cli,支持 Rust macro like 式的注解式声明,无需编写任何样板代码
- 完全面向数据的代码设计,除了实现 Clang 要求的回调接口,几乎不用虚函数。大量使用
std::format、std::expected、std::ranges、std::views等现代 C++ API,不使用 legacy 的 C++98/11 的过时 API - 完全封闭可复现的构建流程,使用 Bazel 进行封闭构建。采用统一的 xclang 工具链进行编译,提供统一的跨平台交叉编译体验。编译产物高度优化 (PGO + LTO),构建产物除了 system library 无任何依赖
一直有关于 module 等现代 C++ 特性是否可以使用的讨论。现在 clice 告诉你,是的,当然,完全可用!它们可以用于编写 clice 这样拥有数十万行代码的复杂软件,这或许就是我们理想中现代 C++ 的模样。但是另一方面,现有的生态确实如此不方便,以至于为了走通这套流程,我花费了大量的精力来跟进适配它们。
Language Server
接下来是 clice 的主要功能介绍
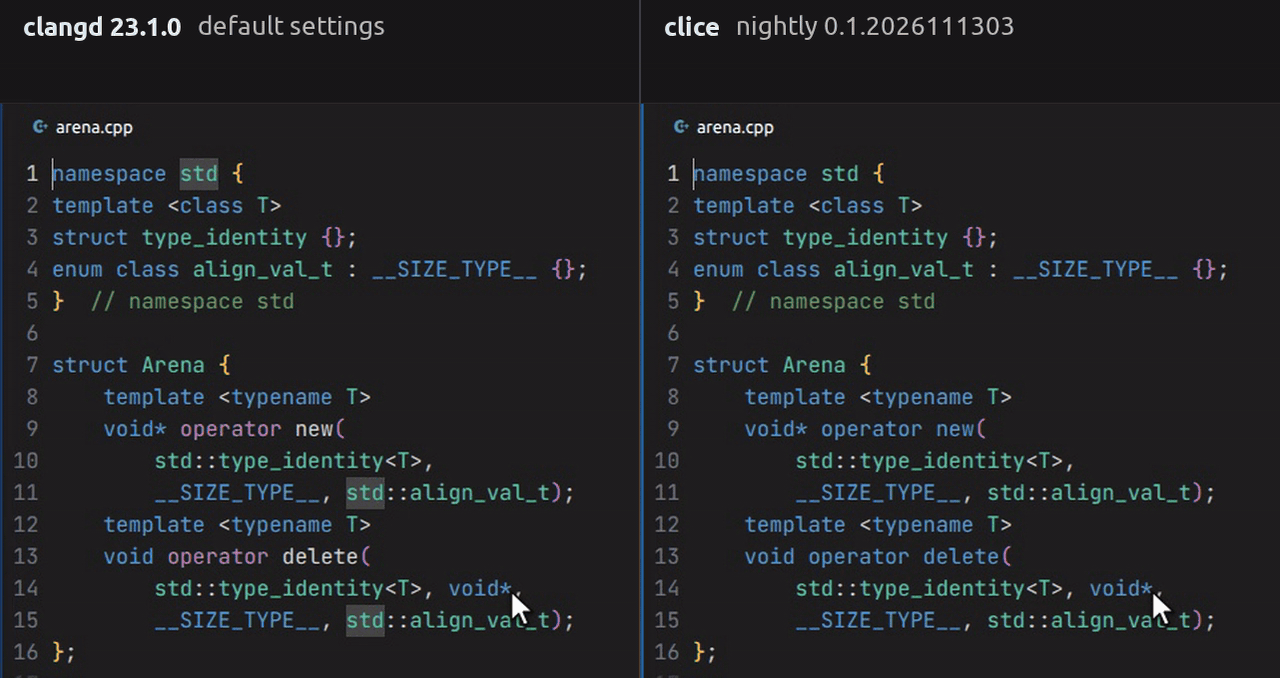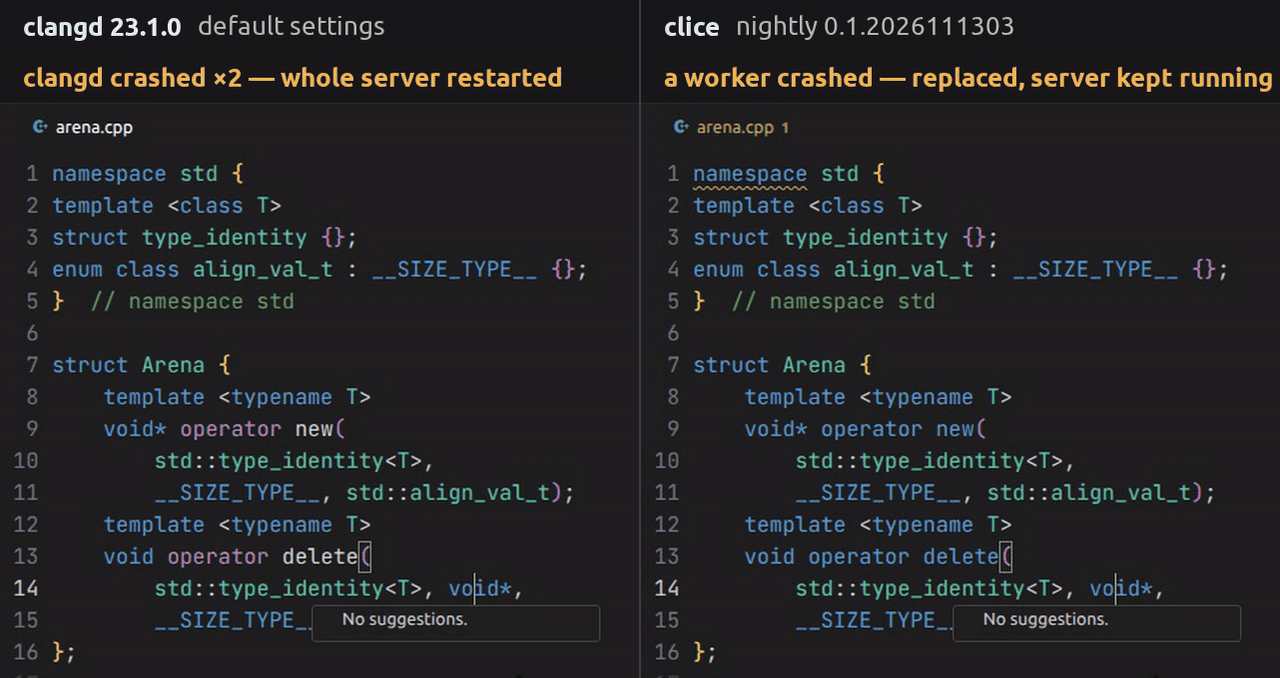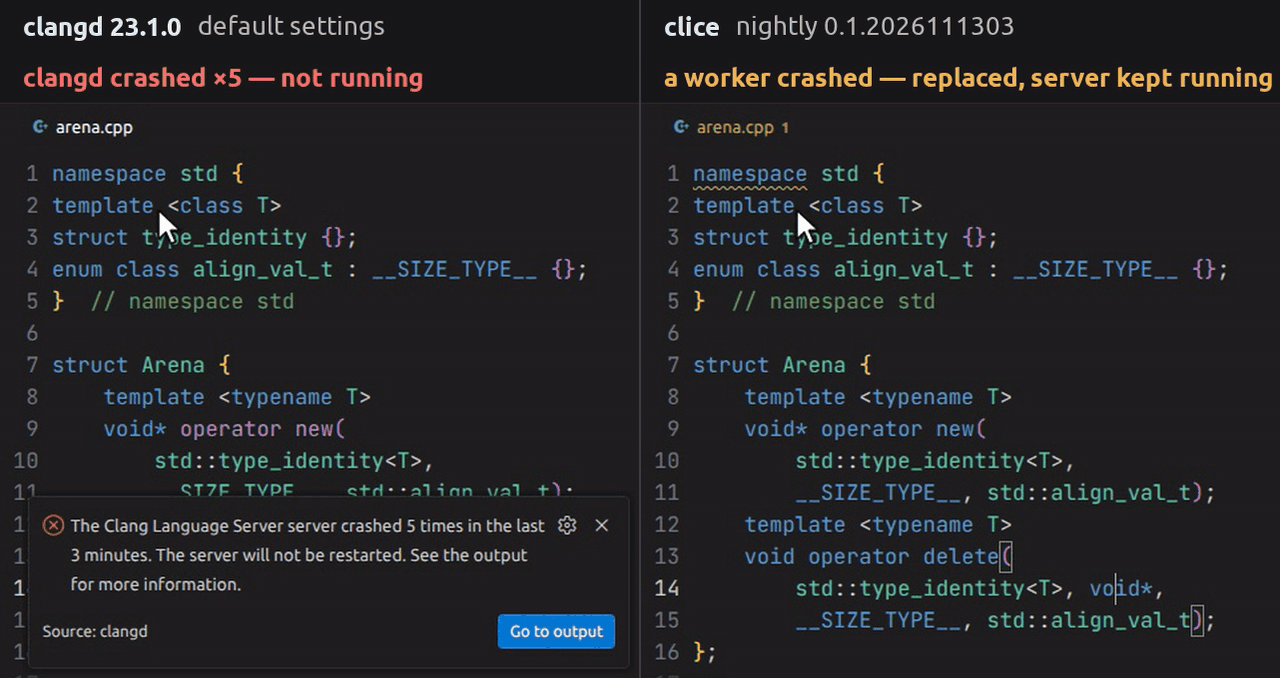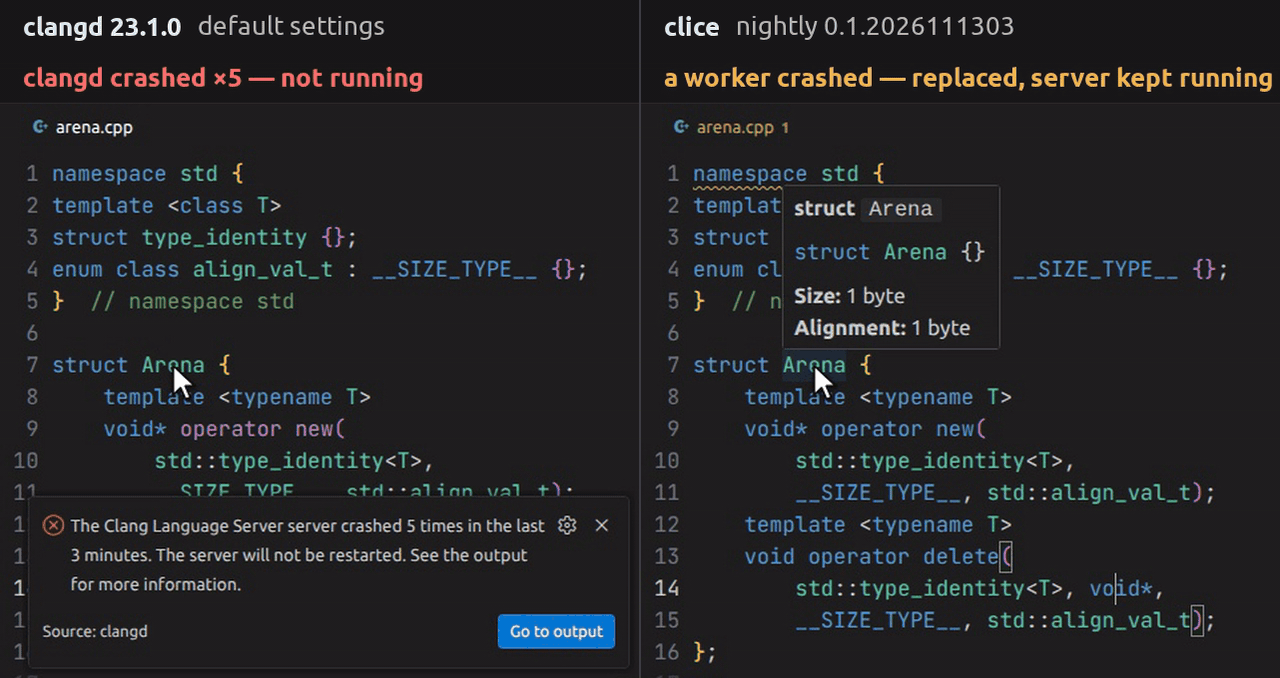
- 多进程编译:clice 采用类似现代浏览器设计的进程池来进行编译,clangd 则采用多线程。为什么采用多进程?这是因为 C++ 实在太过复杂,对于某些 corner case 编译器很容易崩溃或者产生内存泄漏。尤其是对于正在编辑的不完整代码,这里有广泛的下游用户验证编译器在完整代码上的正确性,但是验证不完整代码的人则非常少,编译器往往采用启发式的猜测尽力而为。对于 clangd,如果编译崩溃,则整个服务器都必须要重启。对于 clice,编译发生在隔离的子进程,一个 worker 崩溃并不影响其他服务,跳转高亮之类的仍然可以处理。并且也可以更好地管理内存使用和编译优先级调度,降低不必要的资源消耗。
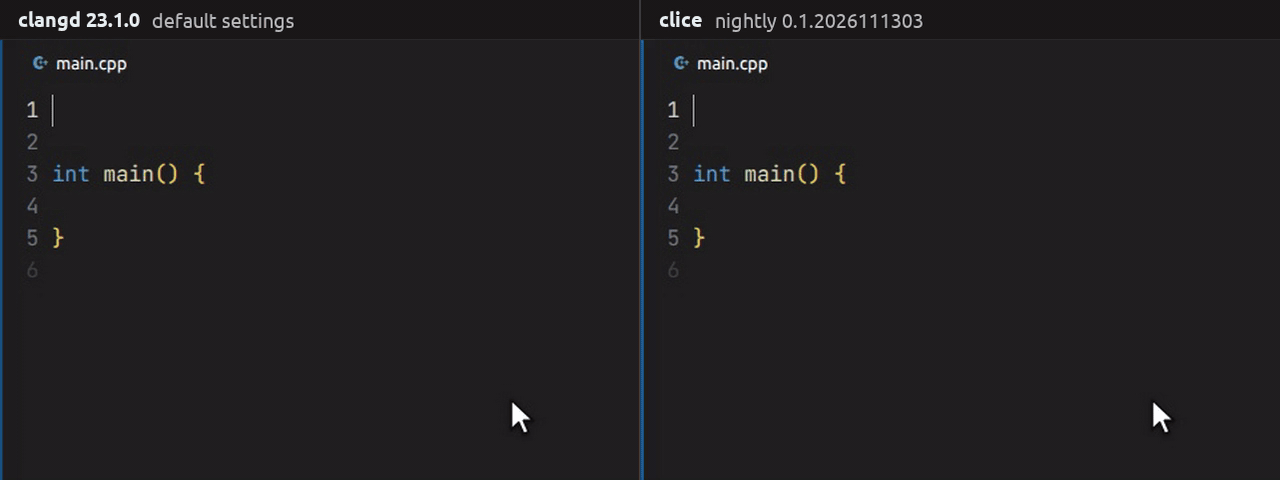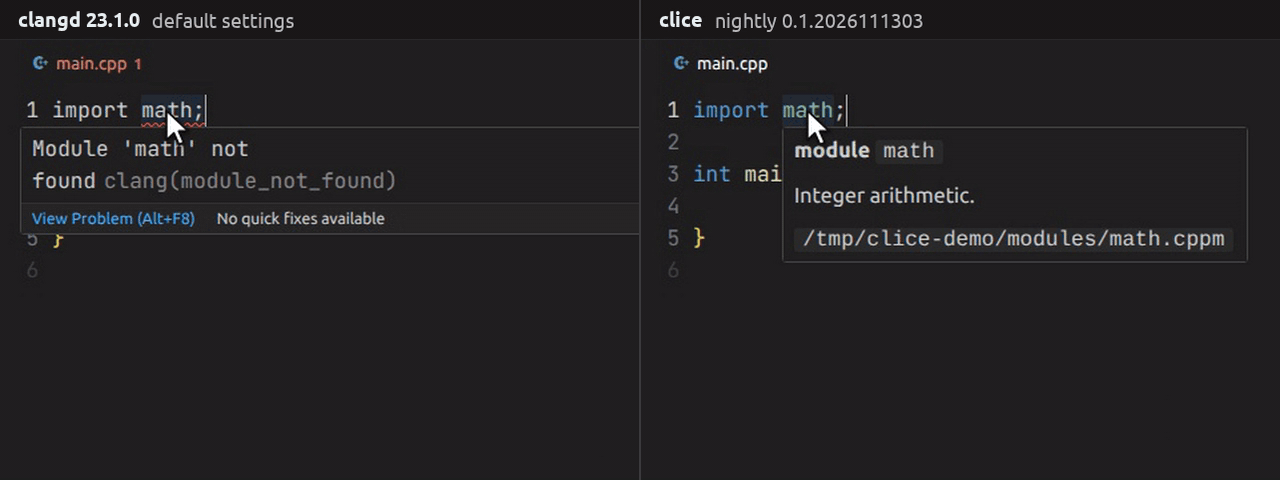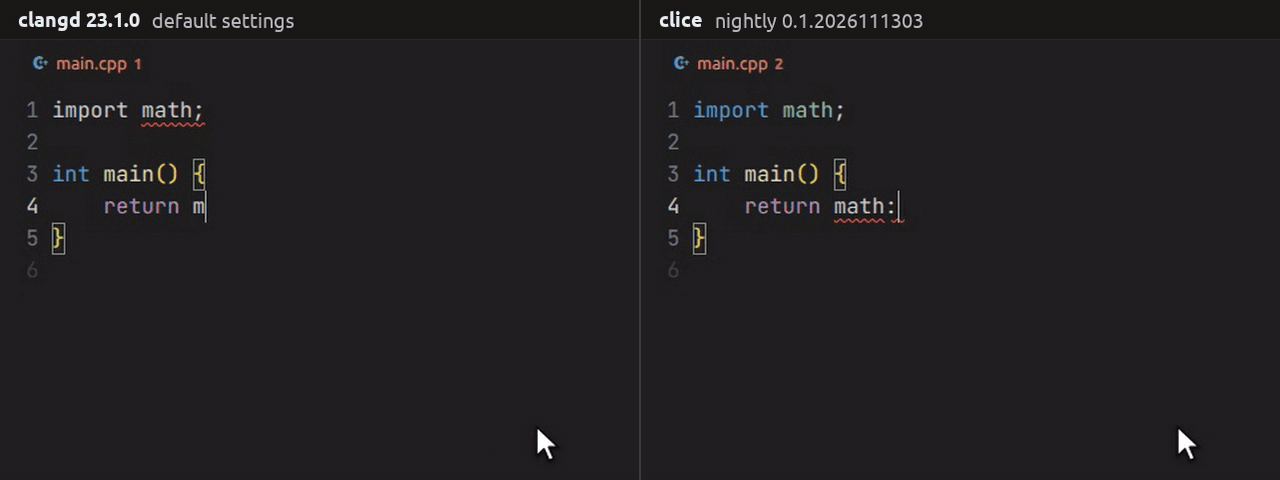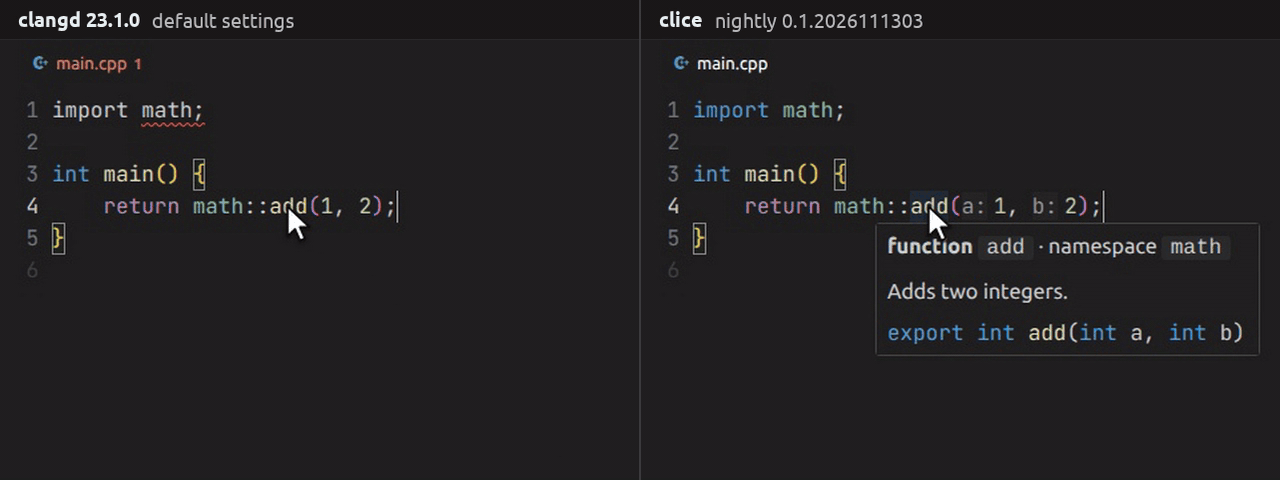
- 模块和共享缓存:clice 具有完整的 C++20 named module 支持。只需提供一份含有所有模块文件的
compile_commands.json文件,clice 便会自己进行依赖扫描,然后按需 lazy 构建所需要的模块,无论你使用的是什么构建系统或者编译器。并且提供完整的模块补全、高亮、跳转、悬浮等功能支持。同时会将构建的 PCH 和 PCM 缓存在本地磁盘上,供不同会话之间复用。相比之下 clangd 只提供了十分有限的模块功能支持,并且不支持持久化缓存。
- 编译上下文:clice 完全支持非自包含 (non-self-contained) 的文件,更一般地说,支持编译上下文 (compilation context) 这个概念。你可以显式选择这个文件的工作上下文,对于源文件来说是不同的编译命令,对于头文件来说则是被包含在不同的位置。并且在你打开非自包含文件的时候会做自动探测,从而提供开箱即用的非自包含文件使用体验。也支持更通用的编译分组概念,允许你为不同的编译配置进行分组。比如说可以在 debug 和 release 之间切换编译命令
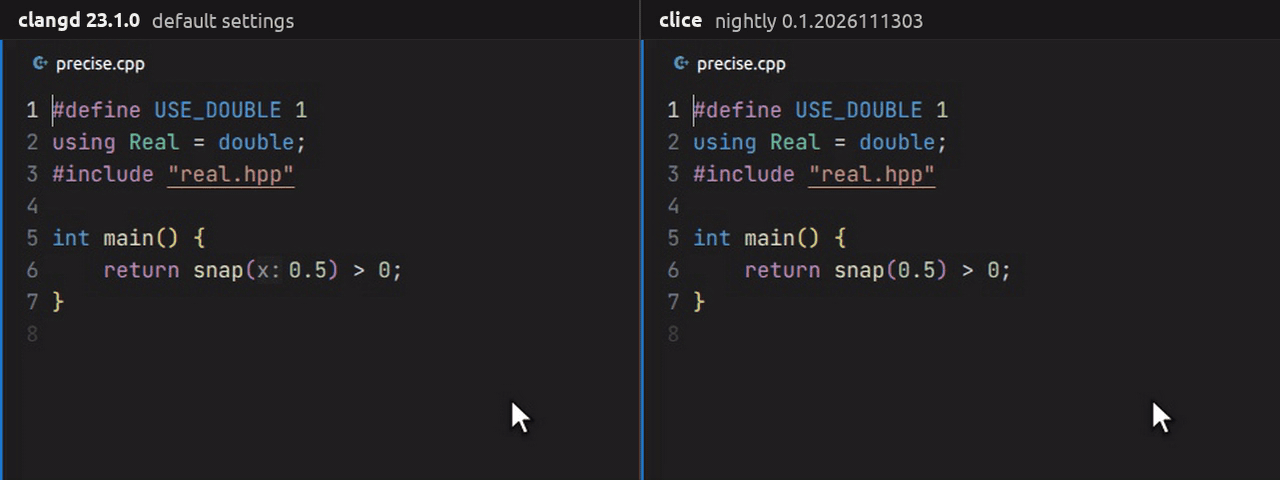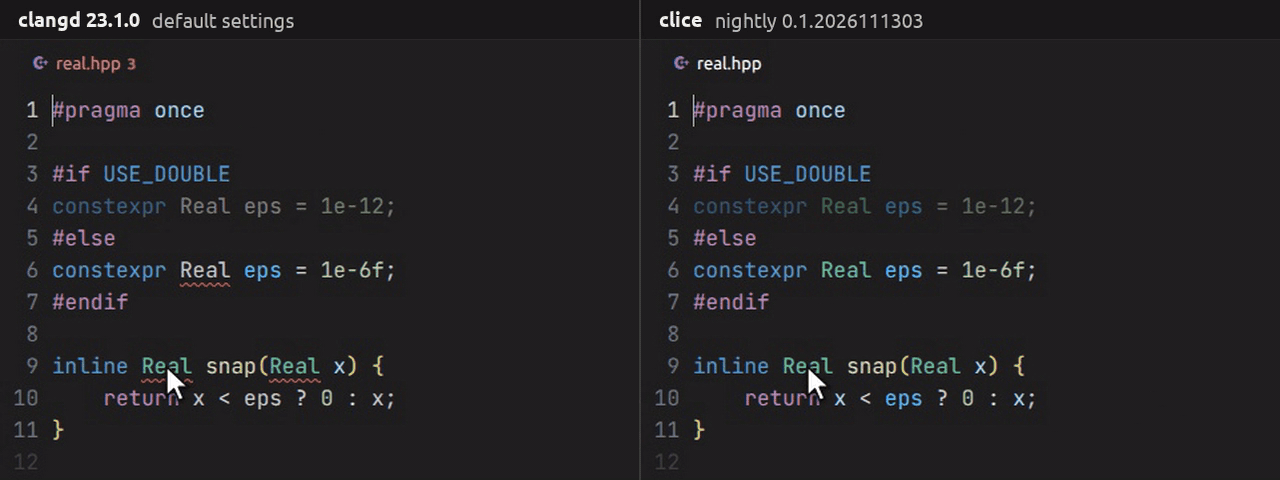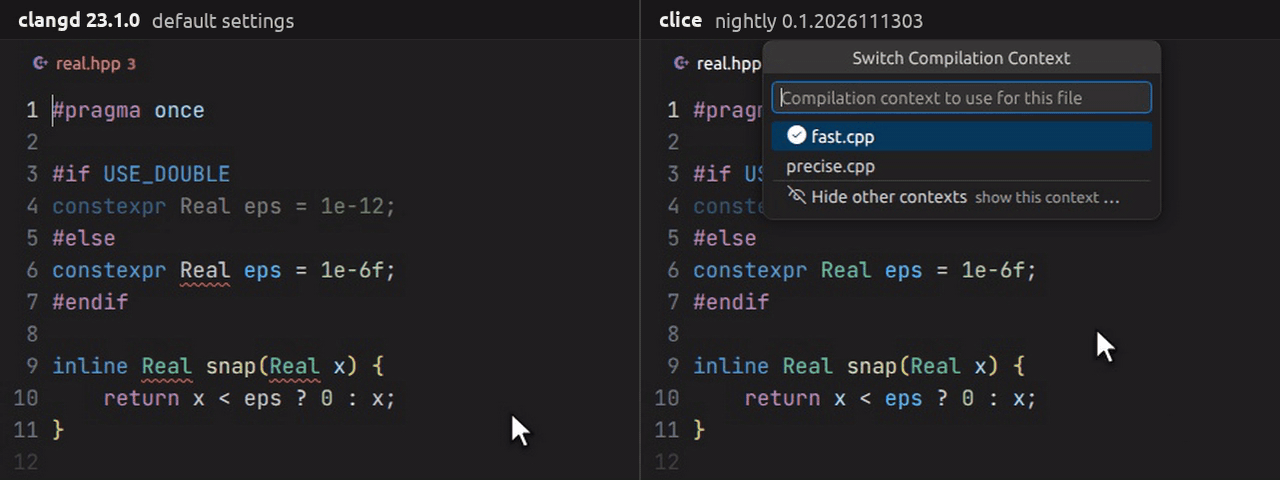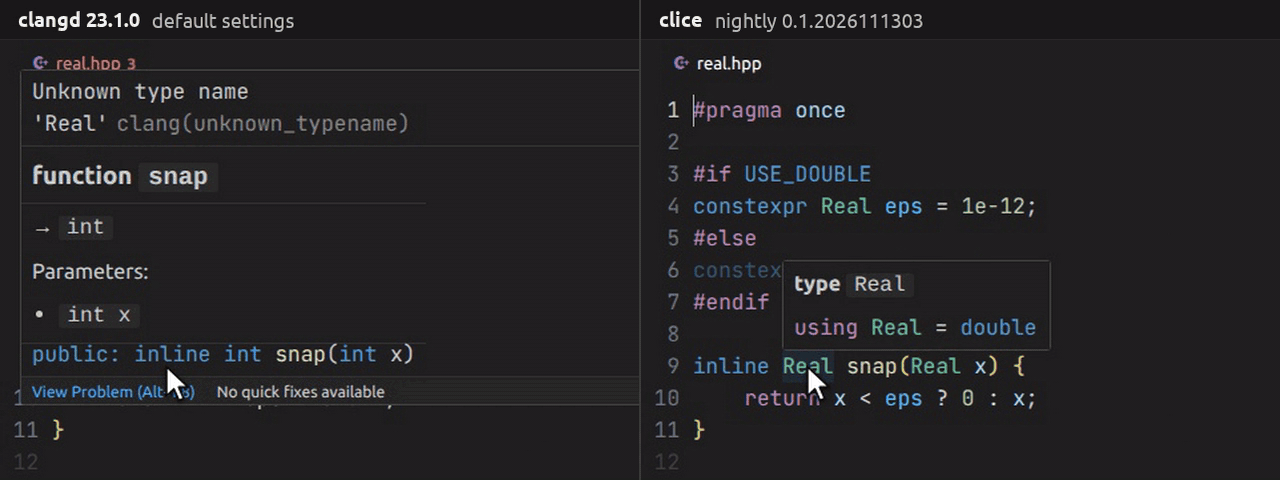
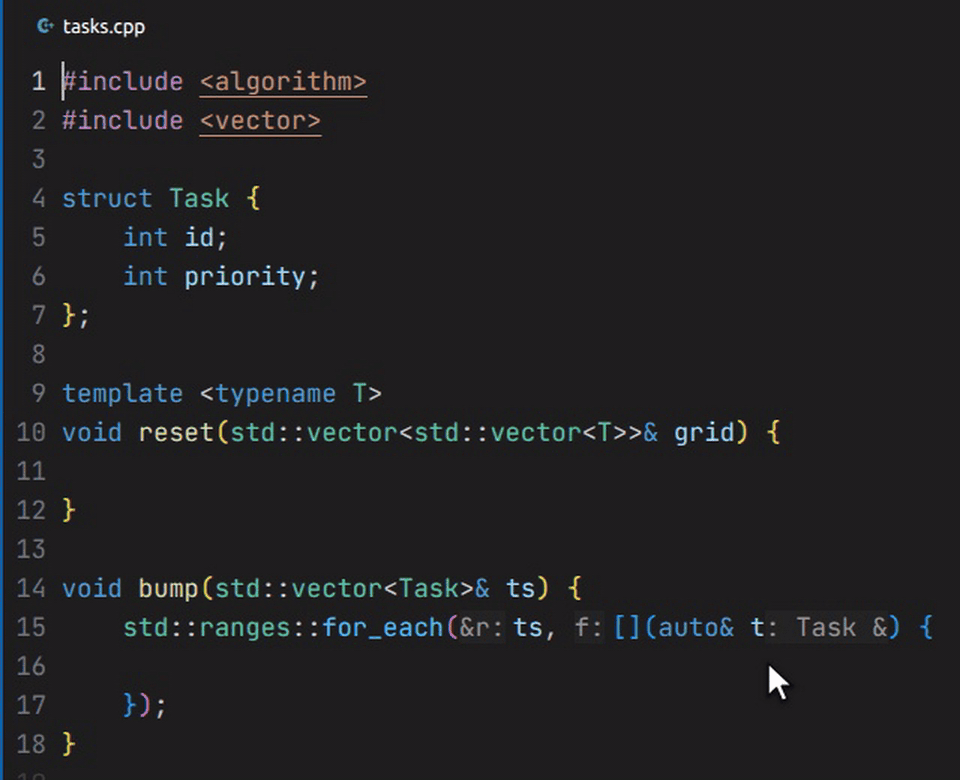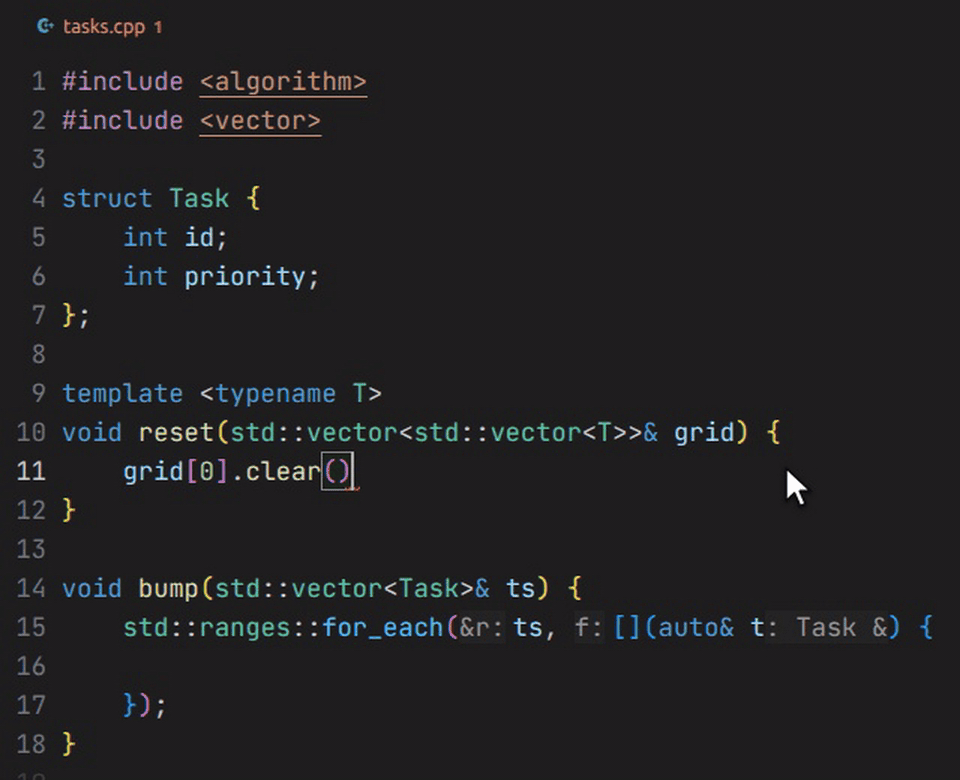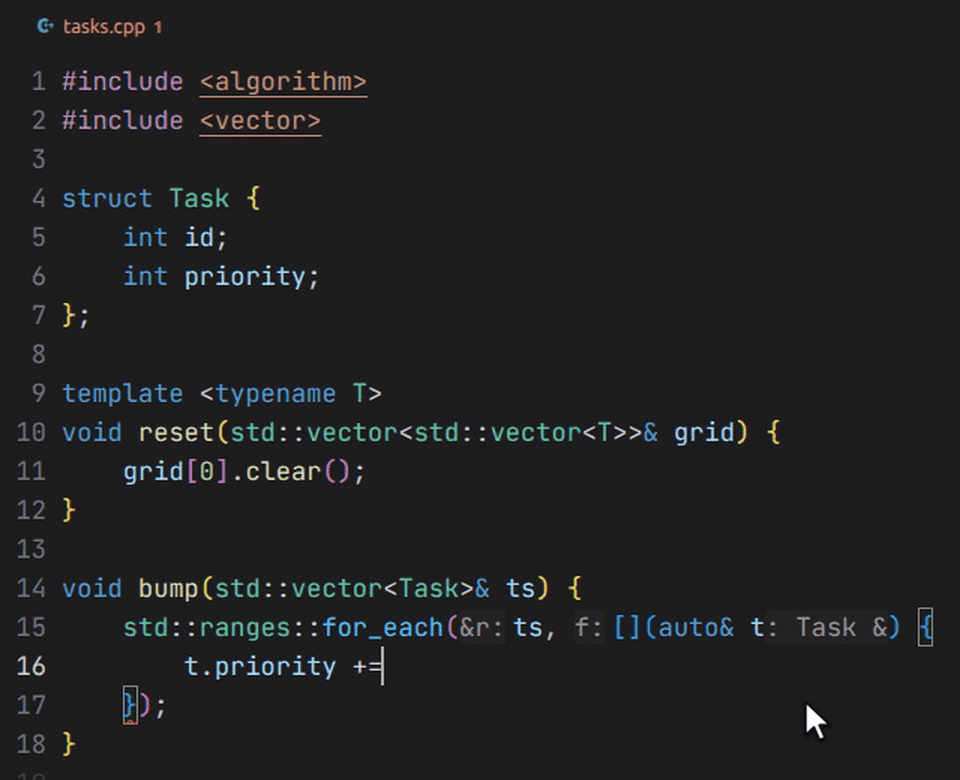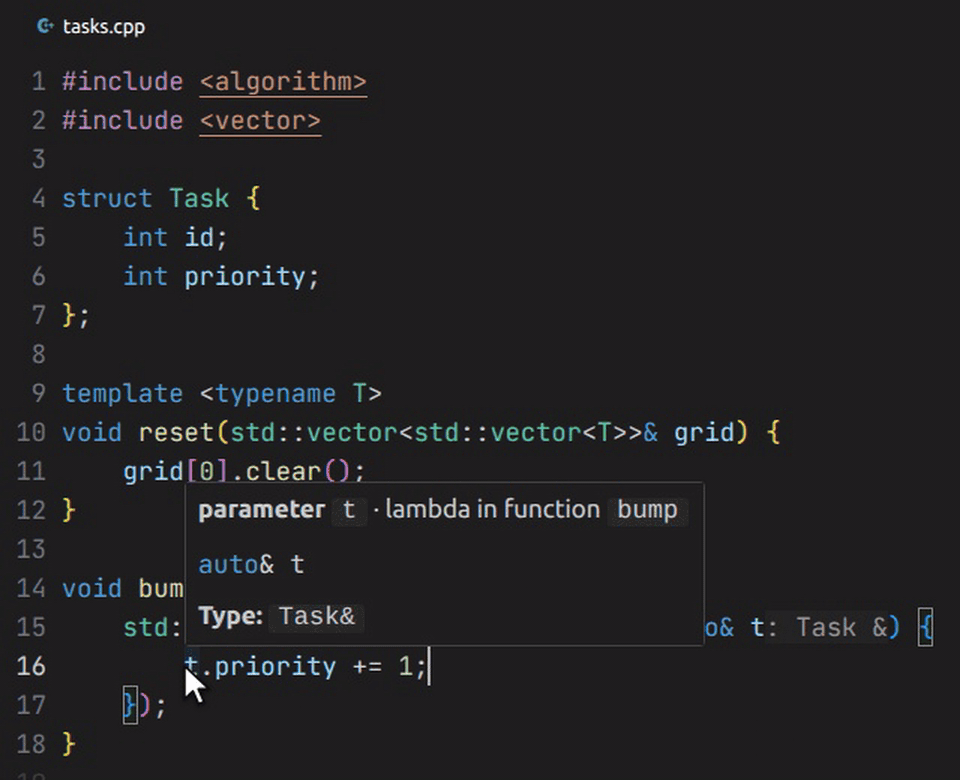
- 更好的模板支持:clice 实现了一个 DFS 伪模板实例化器 (pseudo instantiator),不需要具体的模板参数进行确定的实例化,就推断出很多依赖名的指向。如果模板被实例化过一次,还会额外使用这次实例化的结果来提供语言服务,例如
ranges调用 lambda 的 auto 参数补全。另外,clice 把模板看成一个鸭子类型 (duck type) 的接口,每一次实例化都是它的一个实现,就像虚函数和它的 override 一样:在模板里的依赖调用上跳转到实现,会列出它在每次实例化里实际调用的函数,查找引用和调用层级也是如此
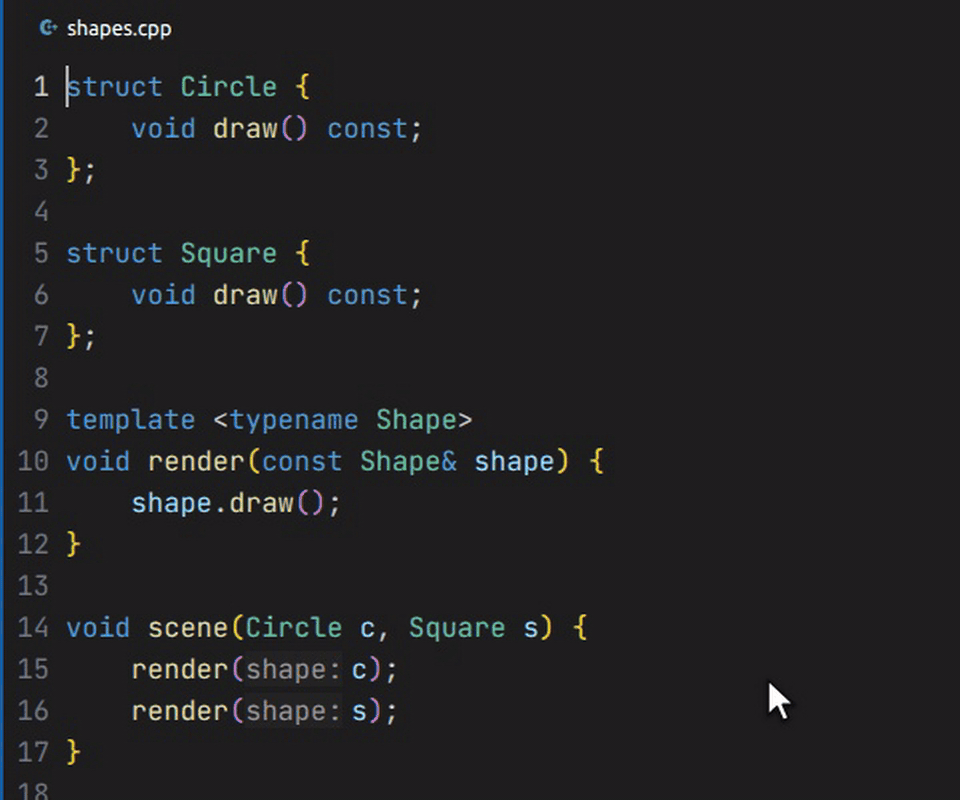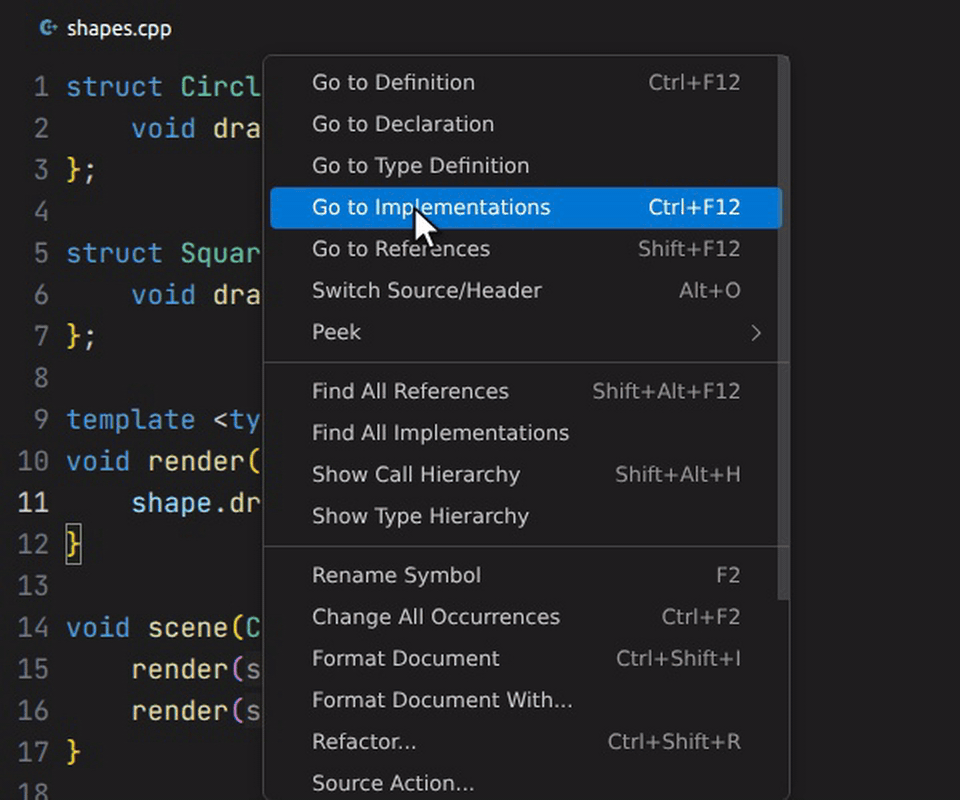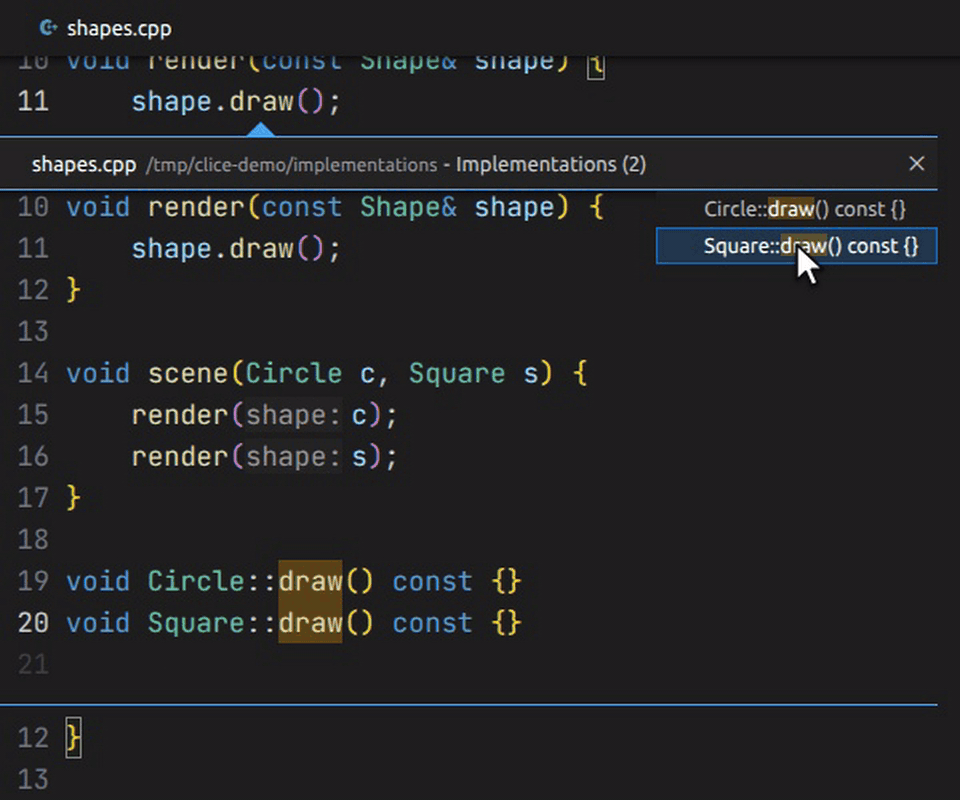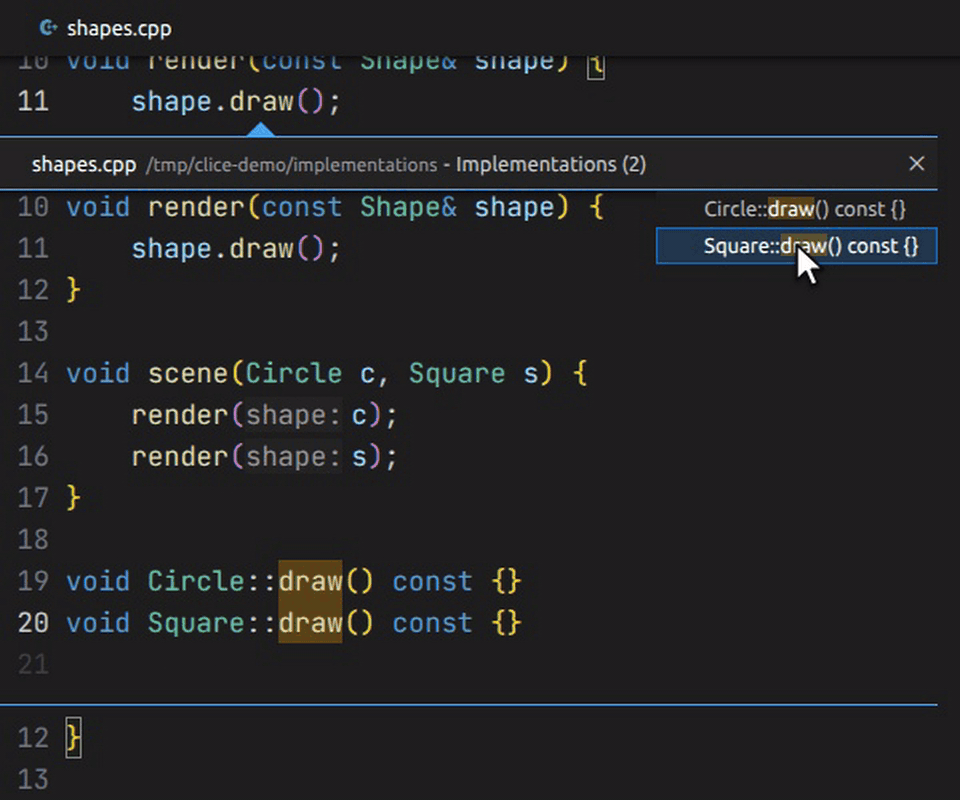
- 开箱即用的使用体验:绝大多数项目只需要一份
compile_commands.json即可使用,clice 内置了 50+ 工具链的环境探测,涵盖 nvcc、msys2、cygwin、zigcc 等等。会自动处理好实际使用的编译器和 Clang 不一致的问题。无需像 clangd 那样在配置文件中手动添加大量的编译选项。
除了这些主要的特性,clice 还解决了 clangd 长期存在并且无人问津的很多小 issue,涵盖语义高亮、折叠、悬浮等功能,感兴趣的读者欢迎立即使用,看看能收获哪些惊喜。总的来说,clice 在易用性、功能支持和性能上均超过 clangd。现在就可以立刻在 vscode 等编辑器中 clice 插件安装并使用。
Command Line
除了作为语言服务器,clice 还可以作为 CLI 工具直接访问各种语言功能。目前已经支持的有:
clice index:提前为整个项目构建持久化索引并支持中断续跑,建好之后打开编辑器可以直接热启动clice lint:内置了 clang-tidy,用进程池并发检查项目里的编译单元并合并头文件的重复诊断,加--index还能复用同一次解析顺便把索引建好clice format: 对 clang-format 的封装,可以自动根据配置文件或者 CDB 寻找需要格式化的文件,并行高效地完成格式化clice command:查看某个文件经过规则改写和工具链探测后的实际编译命令,或者把compile_commands.json转成解析好的-cc1命令给其他 Clang 工具用clice query:无需启动服务器,直接读取磁盘上的索引并以 JSON 输出符号定义、引用、调用图、继承层级和文件依赖等信息clice refactor:直接基于持久化索引改写源码,不需要重新编译,支持跨项目的符号和宏重命名,也可以通过--spec一次性批量改名clice analyze:基于索引输出重构所需的项目结构 JSON,比如analyze modules可以分析目录间的模块依赖与循环依赖,并列出阻碍模块化的代码写法clice modularize:把项目用到的三方库自动包装成 C++20 模块,不用改任何源文件;也可以按analyze给出的划分,把项目自己的代码改写成模块单元,头文件变成分区,#include变成import。clice 的模块化就是这个工具自举完成的
The story behind it
功能介绍到此结束,接下来有必要谈谈这个项目背后的故事,一些设计决策和我个人的思考与挣扎,尤其是在这个特殊的 AI 时代。
Why not improve clangd?
首先为什么要编写一个新的项目而不是改进 clangd?这是最常被问到的问题。这里有多方面的原因,在我最早期的 文章 中有一些阐述,现在你将更直观地看到这些问题:
- 关于投入问题:最根本的问题是 clangd 从 2024 年前后开始基本处于实质上无人维护的状态。这很令人惊讶,数十万开发者使用的工具怎么会无人维护呢?2024 年我准备给 clangd 提模板内代码补全改进的 PR 的时候意外发现了这个事实。据我了解,这与 Google 对 C++ 的策略转向有关,在这之前 clangd 主要由 Google 的数名员工维护,而在 2024 年前后,Google 对 C++ (Clang) 的投入开始减少,clangd 也被认为已经满足了 Google 内部的代码需求,从而原有的数名员工都被调离去做别的工作了。在那之后 clangd 缺乏实质上的长期维护者,只有 Nathan Ridge 完全出于热爱(无任何薪酬)在业余时间解答问题,但是一个人的精力有限,几乎无法处理大型 PR。这也就是 clangd 的模块化 PR 拖了将近一年的原因,并且时至今日仍然无法正式地在大型项目使用,存在诸多缺陷,无人处理。2026 年,也就是今年,Clang 的 lead maintainer Aaron Ballman 意识到了这个问题,在社区的论坛上发了一个 求助帖,说 clangd 已经非常接近无人维护,积压了大量的 PR 和 issue,希望能找到新的社区维护者,否则 clangd 最终有可能会被从 LLVM 项目里移除
- 关于代码规模:正如文章开头所说的,clice 做了大量的架构创新,比如多进程编译。如果要在 clangd 里面实现这些功能,那接近于重写 clangd。这样大规模的改动不可能有人 review 并接受。并且想要实现模块化自举,LLVM 的构建流程也会有巨大的修改,这一点我会在后续介绍 xclang 的时候详细说明
- 关于 LLVM 仓库的限制:clice 依赖大量的三方库来获取更好的性能和用户体验,比如
libuv、simdjson和tomlplusplus等,LLVM 出于构建便捷的考虑,要求自包含,不可能引入这么多的三方库。要么将它们重写移植到 LLVM 中,要么忍受功能上的不便利和性能的低下。此外,语言服务器并不是一个独立的项目,它还包含各种编辑器的插件适配部分。为了方便维护,当然和语言服务器放在一个仓库比较好,而 LLVM 同样不太会接受这些代码(包含 Rust、Lua、TS 等语言)。所以从长期维护便捷性和我们的核心目标来说,独立的仓库势在必行
于是,在 2024 年中,我开始研究如何设计和编写一个新的语言服务器,并在 2024 年底发布了 一个新 C++ language server 的设计与实现,确立了 clice 开发的核心目标,并正式开始开发 clice。
How did we get here?
接下来讨论下 clice 的开发过程,它是如何走到今天这个最终状态的?在过去的两年半时间内,粗略估计,我已经投入了将近 3000 小时在这个项目上。不过这并不准确,实际上它已经成为我生活的一部分。这是一种 keep in mind 的状态,就像吃饭睡觉一样,我无时无刻不在思考这个项目相关的问题。整体的开发过程大致分为四个阶段:
2024 年中至 2025 年初:在这个阶段我主要在研究和学习 Clang/clangd 相关的代码和机制。查看我以前的博客可以发现,我是一位资深的模板元编程爱好者,对 C++ 语言和各种实现细节十分熟悉,乃至到语言律师的水平。在这个阶段主要是确立了 clice 的核心目标和总体设计,搭建了项目的 demo。此时我还是大三学生,睡醒了就开始写代码,午饭都不吃,饿了再去门口吃麦当劳,一天可以投入 8-10 小时。
2025 年初至 2026 年初:原本预计在这个阶段,我应该会很快地推出一份可用的 clice 实现。但是项目的进展比我预想的慢很多,远没有达到生产可用的阶段。现在回头看,这主要有下面几个原因:
- 最重要的就是时间投入,原本我预计这个阶段我仍然会像之前那样每天投入 8-10 小时。但是我的本科专业是化学,编程相关的知识都是自学的,尽管在 C++ 方面颇有经验并且参加过 GSoC,但是缺乏特定的「领域知识」。为了找到一份工作,我在 2025 大多数时间都在实习,学习新的领域(而不是 C++ 前端),同时我还得处理学校里的琐事和毕业相关的事情,能投入到这个项目中的时间相比之前的假设就大大减少了,进展自然缓慢很多
- 同时为了让项目真的达到生产可用,除了核心的架构代码,还需要处理 C++ 数不清的语法细节,以及各种不同平台的细微差异,比如说 URI 解析、文件路径/唯一性、操作系统的各种差异,工作量比我设想的大很多。并且由于我具有一定程度的强迫症,我总是不喜欢勉强就行的方案,为了达成我的目标搓了很多轮子,涵盖序列化、IPC/LSP、async 等等。假设当初采用 Rust 编写,在 Rust 社区这些设施早已是现成并且被别的语言服务器实现高度验证过的了,也许可以大大缩短项目开发时间。不过用 Rust 编写 C++ 语言服务器感觉很奇怪,并且没法完成我的自举设想,最终也就没有采用。
- 缺乏复杂软件的排期/管理能力。虽然工作很多,但是当时已经有一些早期贡献者对项目感兴趣,并且愿意投入很多时间帮忙编写。但遗憾的是当时的我缺乏 teamwork 的经验(毕竟我是完全自学编程,当时的经验也不太多,总共才学习了三年),所以并没有有效地转化这些贡献。这一点在我现在实际参与工作后有了更深的感受,我的同事们 3-4 人可以各种分工,花 2-3 月从零把一个项目搭建起来然后成功上线,相比之下我就没有太好的项目排期意识,经常是想到哪写到哪。当然,开源社区的投入强度和正式工作肯定不能比,但总之,确实没有很好地建设社区和推进项目
2026 年初至 2026 年 7 月:事情的转折点是以 Claude Opus 4.6 为首的 coding agent 开始流行,我开始尝试使用 agent 辅助编程,帮我处理大量琐碎的细节和折磨的跨平台 debug 工作。我发现它十分擅长这样的事情,在这个阶段我对之前的代码进行了大规模的清理,奠定了现在 clice 的原型。随着 agent 能力越来越强,我开始让它处理越来越复杂的事情,持续快速地推进项目。在这个阶段我感到十分兴奋,终于可以不用再把时间浪费在这些琐碎的细节上,可以专注于架构设计和功能实现了。并且我意识到 coding agent 会越来越强,未来可能人类完全不再会编写代码,语言服务器还有什么意义呢?因此我开始着手设计和实现 clice 的 CLI 功能。
2026 年 7 月至今:当时我认为时机已经成熟,是时候发布早期测试版本,然后根据用户实际反馈来不断进行改进了。此时语言服务器的核心功能已经实现,完全可以日常使用,但是距离我当初的设想还有一些差距,我开始疯狂地实现我当初的设想,并且优化性能,修复 BUG。10 月,我开始计划 clice 的模块化自举,这是一项十分复杂的工作,因为现在 C++ 的模块支持实在是一言难尽:
- CMake 支持模块,但是如果导入模块的实现单元具有不同的编译选项,即使这些选项不影响 PCM 兼容性,CMake 也会将它们 fork 一份编译。并且 CMake 不支持编译缓存,编译缓存对于 CI 来说十分重要,一般我们使用 ccache 来解决这个问题,但是 ccache 并不支持模块
- clice 要支持的平台十分复杂,涵盖 Windows/Linux/macOS × ARM64/x64 一共六种组合。额外还有 ASan 构建,并且需要使用预编译的 LLVM/Clang 二进制来加速 CI 构建。并且希望使用 C++23
import std,并且构建产物只依赖系统库,不依赖其他的动态库,从而用户开箱即用
我进行了广泛的调研,答案是在现有的开源生态中,并不存在这样开箱即用的方案,并且现有的开源模块项目大多数也没有如此复杂的构建需求。在深思熟虑之下,我选择打造了 xclang,其灵感来自 zigcc,为所有不同平台提供统一的交叉编译体验,并且使用 Bazel(自带编译缓存) 彻底解决了这个构建问题。更进一步编写了 clice modularize 工具,自动为我们依赖的所有三方库生成模块包装,至此,彻底完成了 clice 的自举模块化!clice 或许也成了最复杂的使用模块的 C++ 开源项目之一了。
同时在很多开源项目上进行了广泛的 fuzz 测试,修复了大量的 bug,从而让 clice 达到了真正的生产可用状态!
What about agents?
前面提到,为了让 clice 在 agent 时代仍然有一定的价值,我为 clice 设计了 CLI 接口。一个很直观的想法就是使用 clice query 去替代 grep,毕竟更准确,更省 token。这当然没错,但精确的符号查找需要索引整个项目,这会耗费非常长的时间,而 grep 虽然不精准,但是往往只需要 2-3 次便可以找到目标结果,多 grep 出的文本,对 agent 理解项目并不一定是件坏事。也就是说这套 CLI 其实并没有太大用,真正有用的大概是 clice modularize,假设让 agent 去模块化一个项目,它会启动大量的 subagent 同时自己编写脚本来完成迁移,这样的效率十分低下并且成本高昂。让 agent 去使用 clice modularize 这个工具辅助模块化则是更好的做法。LLM 训练的首要目标是泛化性,最擅长的事情就是通过编写各种脚本组合出强大的泛化能力,因此目前来看只有高度特化的工具仍有一定的价值,否则大概不如 LLM 自己用脚本组合。
随着 agent 的能力越来越强,尤其是以 Claude Opus 5.5 和 Fable 5.2 为首的模型的出现,复杂软件的成本变得越来越低,带来过去十倍乃至百倍的生产力是完全可能的。在 X 上,你也可以看到很多人一句话让 Claude 使用另一种编程语言重写 TSC 编译器,并且可以获得更好的性能。乍一看很令人惊讶,但其实很合理。过去编写的软件受制于人的生产力成本和水平,必然存在大量非最优路径的代码,做性能优化我们往往是抓主要矛盾,而 agent 则可以不知疲倦地优化所有路径,积少成多。而且重构很多时候可以给出比现有代码更好的架构,只是在过去重构/重写软件的成本实在太高了。因此在可预见的未来,或许大多数代码将完全由 agent 编写,人类不再会去写代码乃至读代码(实际上现在已经发生),语言服务器也不再有任何存在的必要。甚至 agent 发明了自己更适应的编程语言,因为现在很多时候编译/解释本身成为 agent loop 的瓶颈,而 agent 实际上有能力去优化这些基础设施的效率,只是尚未开始。理想情况下,agent loop 的每一环都应该是 agent 可以自己改进和提效的,当然也包括编译器/工具链。
To be continued
这是个令人悲伤的现实,也意味着我在过去两年半时间内所做出的努力,在这样的时代背景下很难再有我最初设想的那种长远意义。每每想到这,就会陷入到一种负面情绪中,乃至有点虚无主义的想法。我不得不问自己,花费数千小时,还伴随大量的金钱投入,到底是为了什么呢?
由于非科班的野路子自学经历,我早就习惯了自己去寻找目标、定义问题、解决问题,然后再寻找下一个目标的循环。对我来说,兴趣大概是只能支撑一时的投入,如果想要长期地投入到某件事情中,背后必须有某些更深远的「意义」或者「愿景」。如果这个愿景是我自己定义的,那就再好不过了。而现在它的意义正在不断消亡。于是在过去的几个月中,我开始疯狂 push 自己。越是产生这样的想法,越是疯狂地使用 agent 推进项目进度,企图在它彻底失去意义之前完成它。
假如有这样一条 IF 线,coding agent 没有大获成功。我想,clice 的完成度当然不会有现在这么高,但我会逐渐变得更有经验,学会合作和排期,组织起与之相关的社区,clice 会缓慢但是扎实地前进。可是 SOTA 模型已经完成训练,Opus 5.5 和 Fable 5.2 这样的模型是真实存在的,无论 AI 是否是泡沫,它们都不会消失,软件变得廉价已经是无可争辩的事实。
我们必须面对现实,该以什么样的心态对待这件事呢?最近我的想法又发生了一些改变,目前的精神状态/生活状态其实不是太好。过于投入到某一件事情当中,如果这件事最终没有达到预期,当然会对人产生非常负面的影响。但如果把时间尺度拉长,这又算得了什么呢?就算在这两年半时间,什么都没做又怎么样呢?来日方长。道理是这样,但放下是很难的。尤其是在这两年多的时间里,它已经成为了我生活的一部分。之前的文章中提到,从大学毕业其实我没有什么真实感,因为我的生活节奏和毕业前也没什么区别,除了工作就是这个项目。但总要做出改变,把它当成一个毕业设计来对待,一个我真正的毕业设计,而不是我并不喜欢的化学专业。And that’s enough,这就足够了。不再强加太多远大的意义,这个毕业设计已经完成了两年前我制定下的所有目标,并且是超额出色地完成了这些目标。其本身就是现代 C++ 的最好阐释,也是巧妙地将我大学研究的所有 C++ 知识结合在了一起。在此基础之上,对于一些刚学习编程的人,或者对现代 C++ 感兴趣的人,它也能提供一些帮助,这样就好。
这篇文章也因此具有了一种仪式感,我需要从过去的生活中转变出来,去寻找其他值得做的事情,也许是一些代码之外的东西。我仍然会继续维护这个项目,只是并不会像之前那样高强度投入了,实际上现在所有值得做的特性都做得差不多了,后续大概只是根据用户反馈做一些增量的优化和修复。在这样的时代,很难说做什么是对的,或者说你应该去做什么。没有人知道下周乃至明年会发生什么,更不知道人工智能究竟会发展到什么程度。我想也该休息一段时间了,让自己不要去 burn out,才有更好的精力去面对未来的问题。我仍然有一种强烈的意愿,想要继续创造出好的作品。但这就不一定是编程相关的内容了,这也是我下一阶段需要学习和思考的问题。
这就是这篇文章的全部内容了,感谢你的阅读。欢迎使用 clice,有任何问题随时反馈!